AI-класифікація документів із ручною перевіркою
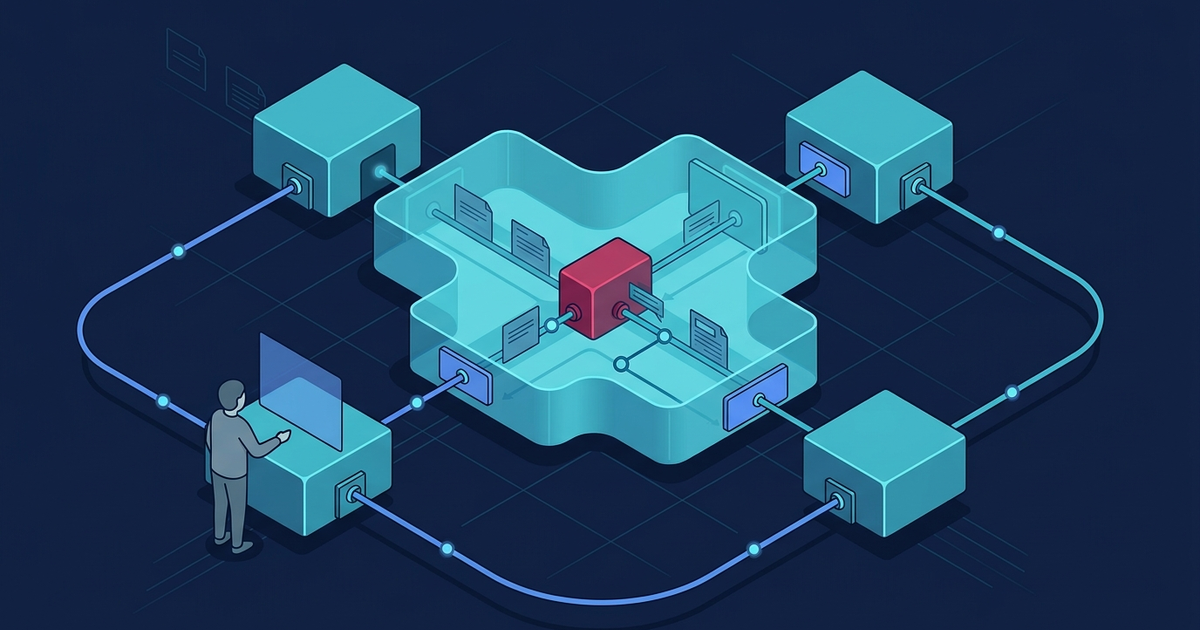
NIST AI RMF 1.0 допомагає організації визначити людські ролі, вимірювати роботу ШІ та реагувати на ризики, а ISO/IEC 42001:2023 задає вимоги до системи менеджменту ШІ (AIMS). Жоден із цих документів не приписує єдину технічну схему HITL: поріг, черга ручної перевірки та журнал рішень є архітектурними контролями, які добирають за контекстом і ризиком.
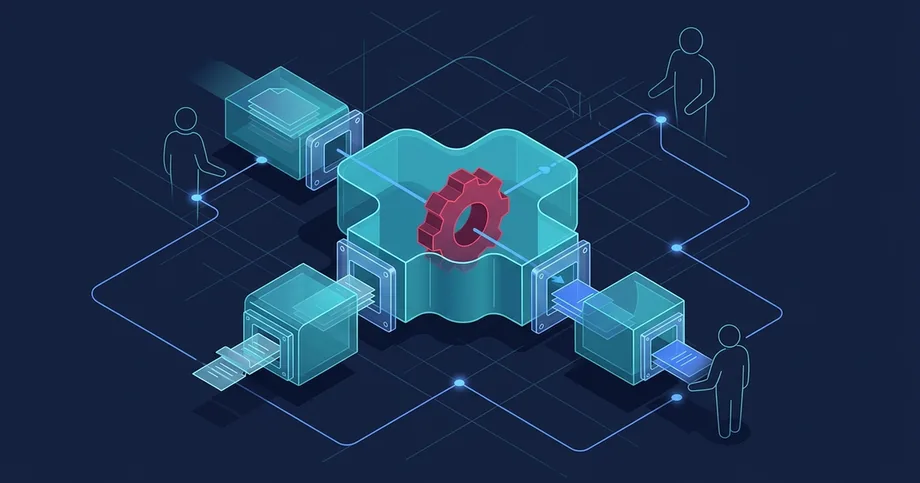
Для класифікації документів корисно розділити три рівні: вимоги до управління ризиком, технічні сигнали невизначеності та операційний процес перевірки. Модель може автоматично опрацювати частину потоку, але передавання документа людині не гарантує правильності саме по собі. Потрібні визначені повноваження оператора, контроль якості рішень, відтворювані записи та правила повернення до автоматичного контуру.
Що насправді визначають NIST AI RMF та ISO/IEC 42001
NIST AI RMF 1.0 — добровільний і незалежний від галузі фреймворк, а не обов'язковий стандарт або технічна специфікація. GOVERN 3.2 передбачає визначення ролей і відповідальності у конфігураціях «людина–ШІ», MAP 3.5 — опис та оцінювання процесів людського нагляду, MEASURE 2.4 — моніторинг поведінки системи у production, а MANAGE 4.1 — реагування, зокрема механізми оскарження, перевизначення рішення, реагування на інциденти, відновлення та керування змінами.
ISO/IEC 42001:2023 встановлює вимоги до створення, підтримання та постійного вдосконалення AIMS на рівні організації. Він охоплює політики, ролі, оцінювання і оброблення ризиків, моніторинг та поліпшення, але не визначає універсальну послідовність threshold → queue → operator. Конкретний рівень людського контролю організація обирає відповідно до контексту, наслідків помилки й установлених контролів.
ISO/IEC 22989 задає базову термінологію і поняття у сфері ШІ. Не слід без точного пункту стандарту приписувати йому конкретне розмежування HITL і HOTL. У практиці AI governance застосовують різні конфігурації людського контролю — від підтвердження окремого результату до нагляду з можливістю втручання. Станом на вересень 2026 року документ ISO/IEC FDIS 42105, спеціально присвячений human oversight, ще перебуває на стадії фінального проєкту.
- GOVERN 3.2 та MAP 3.5: визначають людські ролі, повноваження і процеси oversight відповідно до політик організації.
- MEASURE 2.4 та MANAGE 4.1: пов'язують production-моніторинг із реагуванням, override, incident response та change management.
- ISO/IEC 42001:2023: встановлює вимоги до AIMS організації, а не до одного classifier pipeline.
- ISO/IEC 22989 і FDIS 42105: перший документ є термінологічною основою, другий розвиває окремі настанови щодо human oversight і ще не опублікований як міжнародний стандарт.
Проєктування ризик-орієнтованого контуру ручної перевірки
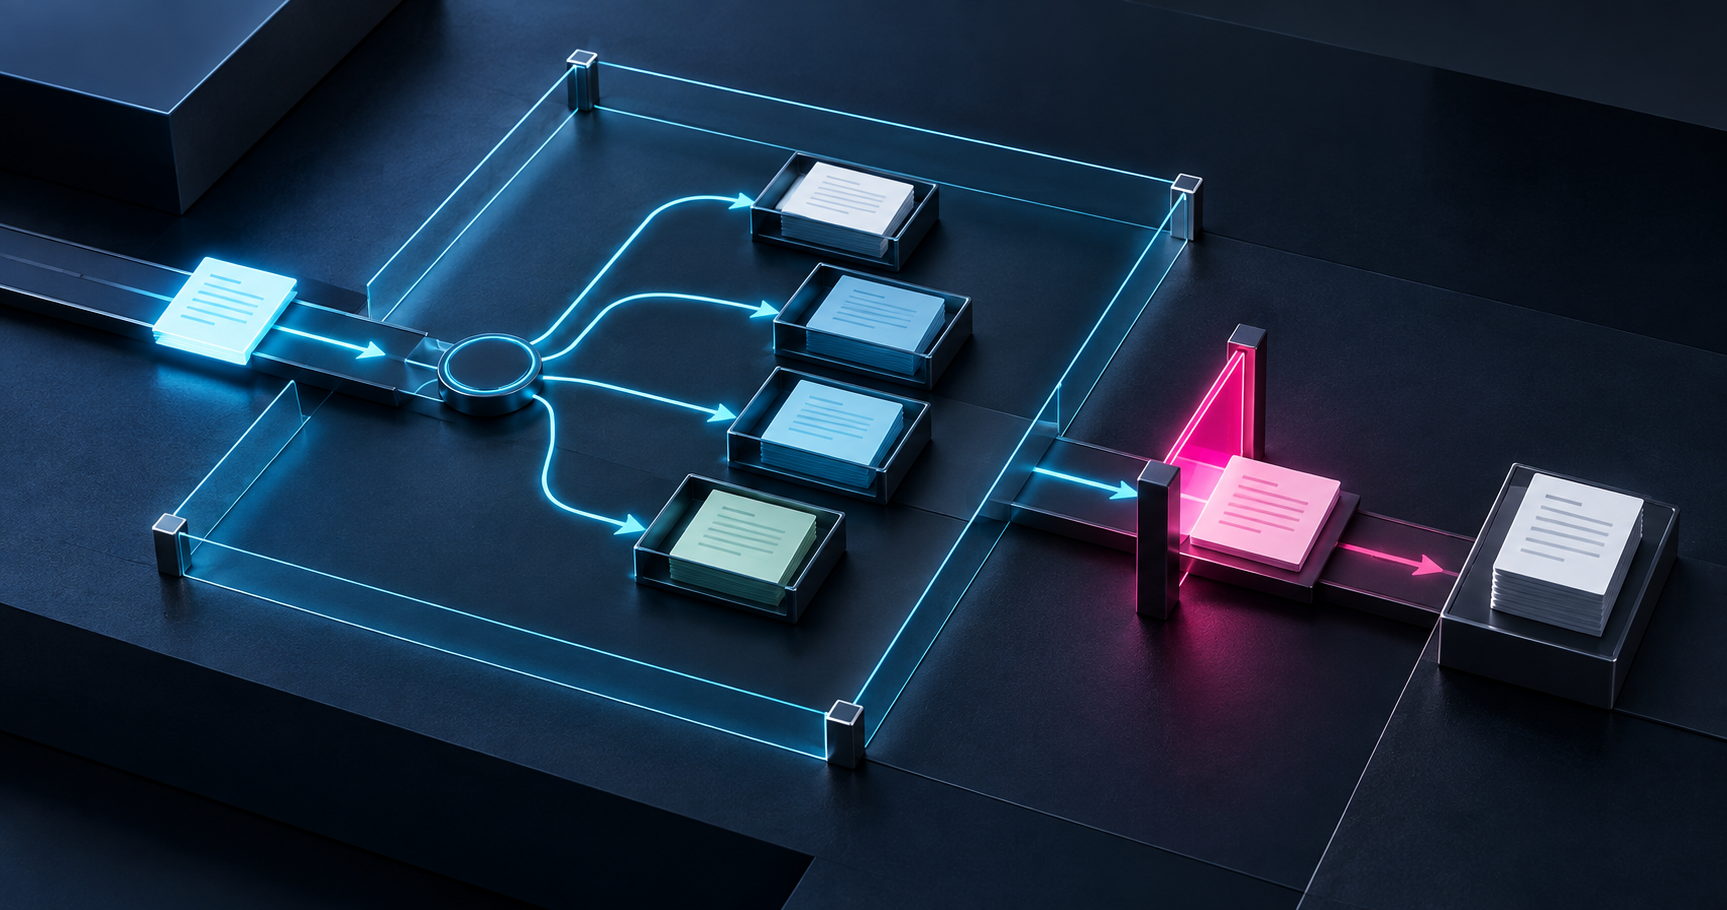
Класифікатор може повертати confidence score, margin або прогнозовану ймовірність класу. Це число не можна автоматично трактувати як імовірність правильності. Наприклад, значення 0.9 відповідає приблизно 90% правильних рішень лише тоді, коли таку калібровку підтверджено на окремій репрезентативній вибірці для потрібного контексту.
Поріг налаштовують за фактичними precision, recall, помилками окремих класів, вартістю false positive і false negative, оборотністю наступної дії та пропускною здатністю операторів. Один глобальний поріг часто поступається порогам для окремих класів або дій. Його слід перевіряти після зміни моделі, шаблонів документів, OCR-конвеєру чи складу production-потоку.
Низький score — лише один сигнал. Високовпевнені помилки можливі після зміни розподілу даних або на незнайомих входах. Тому окремо контролюють якість зображення і OCR, вихід за межі навчального розподілу, наявність обов'язкових реквізитів, суперечності з бізнес-правилами, чутливість класу та ризик подальшої автоматичної дії. OCR/image-quality score і classification score не є взаємозамінними.
Типовий сценарій
Коли рішення треба передати людині
Фінансовий документ може потрапити до бухгалтера через низький score класу, погану якість скану або відсутній обов'язковий реквізит. Для медичного документа перевірка відповідності тексту певному коду є вже окремим завданням семантичної валідації, а не просто класифікацією типу файла. У різних сценаріях система може призупинити бізнес-дію, застосувати резервне правило чи другу модель, запросити додаткові дані, виконати вибірковий контроль або залишити результат для пост-аудиту.
Пороги, маршрутизація та відтворюваний журнал рішень
Ризик визначає не назва файла, а сценарій використання: хто постраждає від помилки, яка дія відбудеться автоматично, чи можна її скасувати та наскільки швидко помилку буде виявлено. Тому наведена нижче матриця є ілюстрацією, а не класифікацією NIST або ISO.
| Сценарій використання | Ризикові сигнали | Можлива реакція |
|---|---|---|
| Платіжний документ запускає фінансову операцію | Низький score, невідповідність реквізитів, велика сума або новий шаблон | Призупинити проведення та передати уповноваженому бухгалтеру |
| Медичний документ впливає на кодування або маршрутизацію | Суперечність полів, незнайомий формат або критичний downstream-вплив | Передати профільному фахівцю; для критичних рішень передбачити повторну перевірку |
| Внутрішня кореспонденція індексується для пошуку | Низький score без незворотної автоматичної дії | Автоматично класифікувати з випадковою вибіркою для контролю або пост-аудитом |
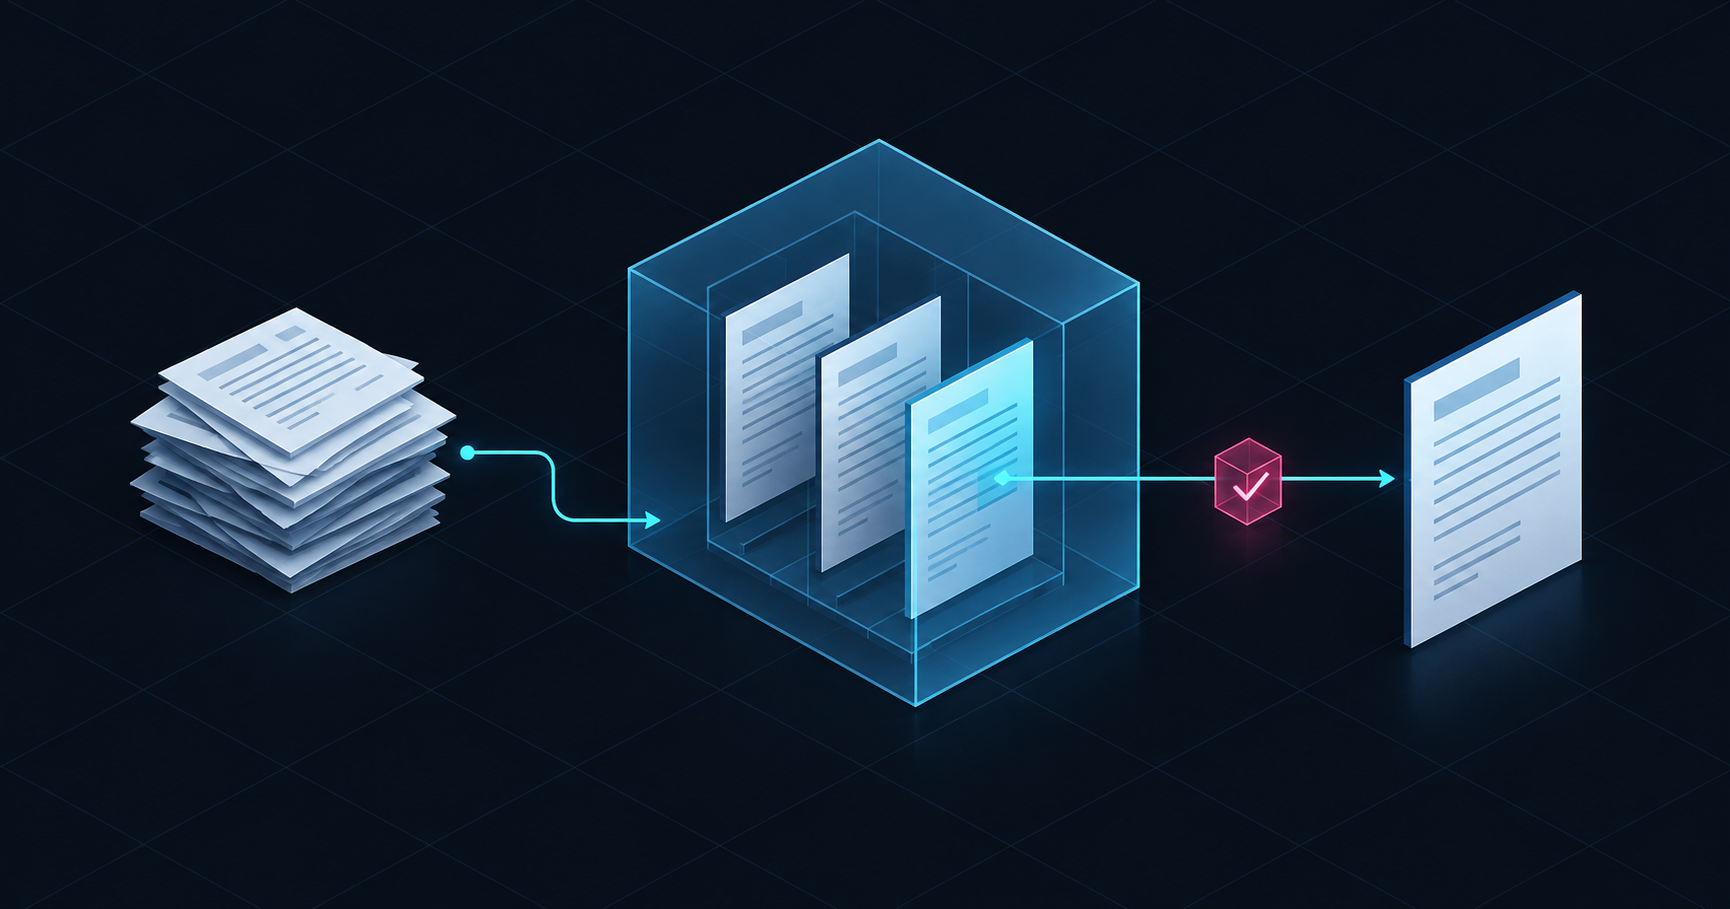
NIST AI RMF Playbook пропонує підтримувати історію, audit logs, статистику override та результати adjudication, але ці пропозиції є добровільними й контекстними. Для практичної відтворюваності доцільно фіксувати ідентифікатор і версію моделі та OCR-конвеєру, версію policy і порогів, прогнозований клас і top-k scores, правило маршрутизації, рішення та обґрунтування оператора, час, роль або користувача, результат повторної перевірки та correlation/request ID. Доступ, строк зберігання й мінімізацію персональних даних визначають окремо.
UnityBase має вбудований audit trail для сутностей, де ввімкнено audit mixin: документація описує користувача, час дії, старі й нові значення та request ID. Специфічні поля AI-рішення — версію моделі, score, поріг і причину виправлення — потрібно явно передбачити в моделі даних та прикладній логіці. Scriptum.DMS надає AI-функції для розпізнавання і класифікації документів, Scriptum — процесний контур на Camunda, а Megapolis.DocNet — BPMN-маршрути й audit trails. Їх поєднання може бути основою HITL-рішення, але не створює повний AI-аудит автоматично.
Моніторинг дрейфу та керований зворотний зв’язок
Зміни форматів, джерел або якості сканів можуть змінити розподіл вхідних даних — спричинити дрейф даних (data drift) — і погіршити якість моделі, але цей зв'язок потрібно підтверджувати за актуальними еталонними даними. Окремо відстежують зміни розподілу вхідних даних і прогнозів, precision/recall для кожного класу, калібрування, частку ручної перевірки, час у черзі, частоту override та фактичну частоту помилок. NIST відносить production-моніторинг до MEASURE 2.4.
Верифіковані виправлення операторів можуть бути кандидатами для оцінювання, аналізу помилок, оновлення правил або prompt, перенавчання чи заміни моделі. Вони не повинні автоматично ставати training data. Черга низької впевненості є зміщеною вибіркою, тому не замінює окремий репрезентативний validation/test set і випадкову або стратифіковану вибірку production-документів.
Перед навчанням суперечливі мітки узгоджують через повторну перевірку або adjudication, дані версіонують, а нову модель тестують поза production. Розгортання виконують керовано: із затвердженням, поетапним запуском, моніторингом і можливістю rollback. Іноді правильним результатом feedback є не retraining, а зміна правила, маршруту, OCR-конвеєру або самої постановки задачі.
Технічний чек-лист HITL-контуру для підтримки AIMS
Цей перелік перевіряє лише технічну частину HITL-контуру і не підтверджує відповідність ISO/IEC 42001. Він допомагає зібрати докази для ширшої системи менеджменту ШІ, де також оцінюються політики, керівництво, ролі, компетентність, ризики, постачальники, внутрішній аудит і постійне поліпшення.
- Контекст і повноваження: зафіксувати наслідки помилок, ролі операторів, право override, ескалацію та випадки обов'язкового підтвердження.
- Валідація порогів: перевірити калібрування, precision/recall і class-specific errors на репрезентативних даних; документувати вибір порога та компроміс error/coverage.
- Сигнали маршрутизації: враховувати не лише score класифікатора, а й якість скану/OCR, OOD-сигнали, бізнес-правила, чутливі класи та випадкове семплювання.
- Операційна спроможність: контролювати розмір і вік черги, цільовий час перевірки, навантаження, навчання операторів та безпечну поведінку при недоступності ручного контуру.
- Відтворюваність: журналювати версії моделі й policy, scores, спрацьований контроль, рішення, обґрунтування, користувача, час і зв'язок із downstream-дією.
- Якість людських рішень: застосовувати gold-standard приклади, вибірковий аудит, second review або adjudication відповідно до ризику.
- Production-моніторинг: порівнювати метрики з baseline, відстежувати drift, помилки, overrides та інциденти й мати правила підвищення або зниження рівня автоматизації.
- Керування змінами: відокремити review data від затвердженого training set, версіонувати набори й моделі, тестувати зміни та підтримувати rollback.
Поширені питання
Як налаштувати поріг і не перевантажити операторів?
Поріг встановлюють на репрезентативній валідаційній вибірці з урахуванням калібрування, помилок окремих класів, вартості false positive і false negative та пропускної здатності черги. Для різних класів і дій можуть діяти різні пороги. Після спостережень у production їх можна як знижувати, так і підвищувати, не покладаючись лише на абсолютне значення score.
Чи достатньо audit trail для відповідності ISO/IEC 42001?
Ні. Журнал підтримує відтворюваність рішень і може бути технічним доказом для AIMS, але сам не підтверджує відповідність ISO/IEC 42001. Оцінюється вся система менеджменту організації: політики, ролі, оцінювання та оброблення ризиків, компетентність, моніторинг, внутрішній аудит і постійне поліпшення.
Як контролювати помилки операторів під час ручної перевірки?
Audit trail дозволяє відтворити рішення, але не визначає автоматично, що воно помилкове. Для критичних класів застосовують повторну експертну перевірку, adjudication, контрольні gold-standard приклади, оцінювання міжекспертної узгодженості та вибірковий аудит. До навчального набору передають лише підтверджені виправлення.
Джерела
- NIST AI Risk Management Framework 1.0
- NIST AI RMF Core
- NIST AI RMF Playbook: Govern
- NIST AI RMF Playbook: Measure
- NIST AI RMF Playbook: Manage
- NIST: Human–AI Interaction
- ISO/IEC 42001:2023
- ISO: AI Management Systems
- ISO/IEC 22989:2022
- ISO/IEC FDIS 42105
- Guo et al.: On Calibration of Modern Neural Networks
- Ovadia et al.: Predictive Uncertainty under Dataset Shift
- Google Document AI: Evaluate Performance
- Google Document AI: Document Quality
- AWS: Create a Human Review Workflow
- UnityBase: Data Changes Audit Trail
- UnityBase: Audit Trail Fields
- Scriptum.DMS
- Scriptum
- Megapolis.DocNet