Поетапна модернізація критичних ІТ-систем: керування ризиками, метрики та сценарії відкату
Новий компонент уже готовий приймати трафік, але схема даних, залежності та процедура повернення на стару версію ще не перевірені разом. У такій точці невизначеності часто опиняються архітектори критичних систем, коли тиск бізнесу вимагає швидких змін, а ризик відмови загрожує операційній діяльності. Модернізація великих інфраструктурних рішень рідко прощає підхід раптової заміни, тому еволюційний перехід стає єдиним керованим шляхом для збереження стабільності бізнес-процесів.
Визначення меж першого етапу та ізоляція функціоналу
Успішна модернізація починається з декомпозиції. Спроба замінити всю систему одночасно створює занадто багато невідомих змінних, що робить пошук причин можливих збоїв практично неможливим. Першочерговим завданням архітектора є виділення найменш зв'язаної, але репрезентативної функції legacy-системи для первинної заміни. Ця функція повинна мати чітко окреслені межі даних і мінімальну кількість синхронних залежностей від інших модулів.
При виборі першого кандидата на заміну не варто чіпати критичне ядро системи, але водночас не слід обирати занадто тривіальні сервіси, які не покажуть реальних інтеграційних проблем. Оптимальний вибір — це ізольований бізнес-процес із помірним навантаженням. Виділення цієї функції дає команді змогу відпрацювати весь життєвий цикл розгортання, моніторингу та взаємодії між старою і новою частинами системи з мінімальним ризиком для основної діяльності організації.
Патерн Strangler Fig та керування ризиками маршрутизатора
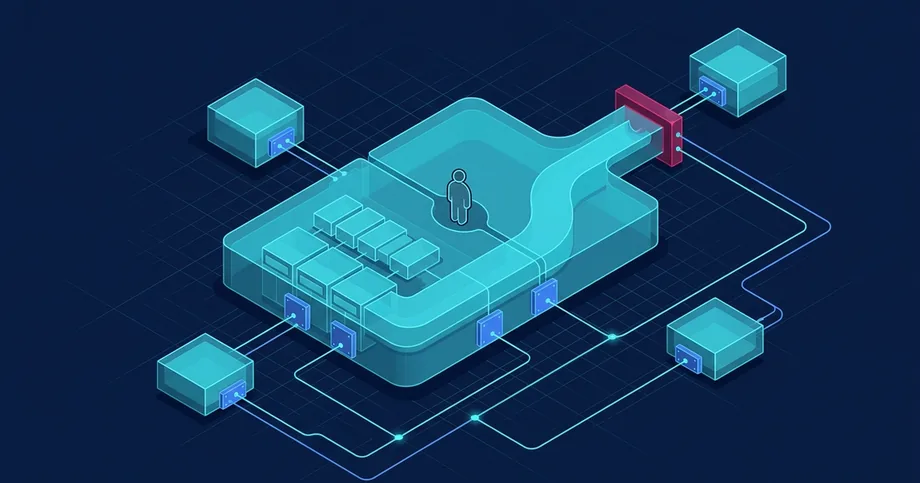
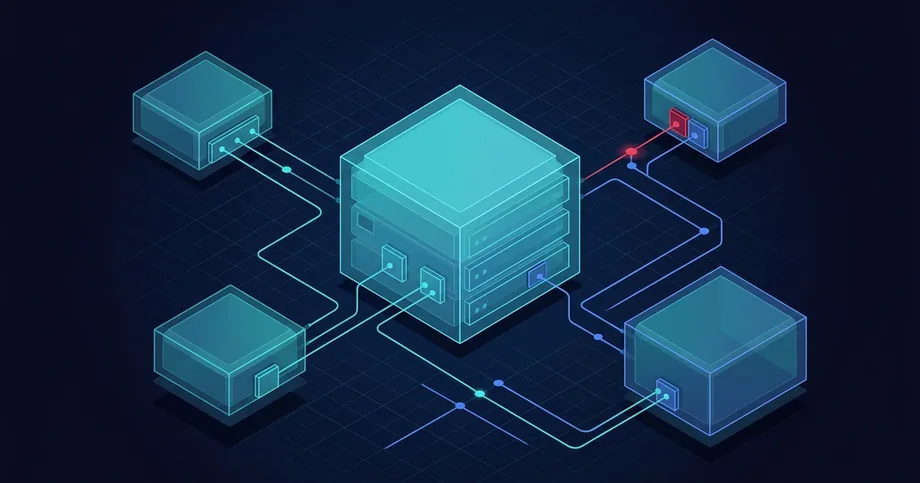
Для поступової заміни функціоналу legacy-системи використовують патерн Strangler Fig. Його суть полягає в поступовому перенаправленні запитів від старих компонентів до нових через спеціальний інтерфейсний шар — фасад. Фасад перехоплює вхідні виклики та маршрутизує їх залежно від готовності нової реалізації. З часом новий сервіс повністю заміщує старий функціонал, і застарілий компонент виводять з експлуатації.
Проте сам фасад стає новою критичною точкою ризику та потенційним вузьким місцем усієї архітектури. Якщо маршрутизатор виходить із ладу, зупиняється вся система. Тому проєктування фасаду вимагає особливої уваги до його відмовостійкості, масштабованості та простоти логіки. Він не повинен містити складної бізнес-логіки — його єдине завдання полягає в швидкому та надійному перенаправленні трафіку.
Для мінімізації подібних архітектурних ризиків IQusion використовує low-code платформу UnityBase як технологічну основу. Завдяки model-driven підходу, де модель предметної області автоматично генерує REST/ORM-API та інтерфейси користувача, суттєво зменшується обсяг ручного коду. Це спрощує створення надійних фасадів для патерну Strangler Fig, налаштування інтеграцій через відкриті API та оновлення окремих модулів без зупинки всієї системи, забезпечуючи при цьому суворий контроль доступу та детальний аудит дій.
Метрики стабільності: розмежування SLI, SLO, RTO та RPO
Безпечний перехід неможливий без чітких кількісних критеріїв оцінки роботи системи. Архітектори мають чітко розрізняти показники рівня обслуговування (SLI) та цілі рівня обслуговування (SLO). SLI — це конкретне кількісне вимірювання поведінки сервісу, наприклад, час відгуку або частка успішних запитів. SLO — це цільове значення або діапазон для цього показника, узгоджений із бізнесом. Абсолютна стовідсоткова доступність не є реалістичною ціллю, оскільки витрати на її досягнення зростають експоненціально, не приносячи пропорційної цінності.
Окрім експлуатаційних метрик, критично важливими є показники безперервності бізнесу: допустимий час відновлення (RTO) та допустима точка відновлення даних (RPO). RTO визначає, скільки часу система може бути недоступною під час інциденту до моменту її повного відновлення. RPO вказує на допустимий обсяг втрати даних, виміряний у часі від моменту останнього збереженого стану.
Успіх модернізації вимірюється не швидкістю написання коду, а здатністю системи повернутися до стабільного стану в межах визначених RTO та RPO при виникненні будь-якої аномалії.
Чому міграція стану потребує окремого сценарію
Популярні стратегії безпечного розгортання, такі як Canary або blue-green, чудово працюють для безстановочних (stateless) компонентів, але вони не вирішують автоматично складні проблеми міграції схем і стану даних. Якщо нова версія сервісу потребує зміни структури бази даних, просте перемикання трафіку може призвести до несумісності та втрати інформації при спробі відкату.
Для stateful-компонентів потрібен окремий сценарій синхронізації та підтримки зворотної сумісності. Типовим підходом є використання стратегії паралельного запису (dual-write), коли дані одночасно записуються і в стару, і в нову бази даних. Такий підхід підтримує обидва сховища в узгодженому стані та забезпечує можливість повернення до старої версії без втрати транзакцій, здійснених під час тестування нового компонента.
Ворота якості та алгоритм оцінки готовності до запуску
Перед тим як розширювати обсяг трафіку на новий компонент, він повинен пройти через систему контрольних точок (quality gates). Ці ворота визначають, чи відповідає поточний стан системи встановленим критеріям безпеки та стабільності.
- Оцінка покриття тестами: Перевірка наявності інтеграційних та регресійних тестів для нового компонента (мінімум 80% покриття критичних шляхів).
- Валідація метрик продуктивності: Порівняння SLI нового компонента на тестовому стенді із поточними SLO legacy-системи під цільовим навантаженням.
- Перевірка плану відкату даних: Проведення симуляції збою з відновленням стану даних до визначеної точки RPO.
- Моніторинг помилок фасаду: Перевірка відсутності аномального зростання 5xx помилок на рівні маршрутизатора при перенаправленні 1% трафіку.
- Готовність служби підтримки: Наявність інструкцій для операторів та налаштованих дашбордів сповіщення про інциденти.
Сценарій контрольованого відкату при виявленні аномалій
Якщо під час поступового перемикання трафіку виявляється відхилення SLI від цільових показників SLO, має бути активований чіткий сценарій відкату. Цей процес не повинен бути хаотичним рішенням чергового інженера — це заздалегідь автоматизований та протестований алгоритм дій.
Першим кроком є миттєве повернення маршрутизації на фасаді до 100% використання старої системи. Після ізоляції нового компонента проводиться аналіз стану даних: якщо були зафіксовані транзакції, які встигли записатися лише в нову базу, запускається процедура звірки та компенсації даних для відновлення цілісності відповідно до встановленого RPO. Лише після повного відновлення стабільного стану legacy-системи команда переходить до аналізу логів та усунення причин інциденту.
Поширені питання
Що таке патерн Strangler Fig і як він допомагає при модернізації?
Strangler Fig передбачає поступову заміну окремих функцій застарілої системи новими компонентами. Спеціальний інтерфейсний шар (фасад) перехоплює запити та маршрутизує їх між старою і новою реалізаціями, знижуючи ризик масштабного збою під час переходу.
Чому Canary-розгортання не вирішує проблему міграції даних автоматично?
Canary-розгортання керує лише розподілом трафіку користувачів, але не структурою збережених даних. Зміна схем даних у stateful-компонентах вимагає окремих сценаріїв синхронізації та підтримки зворотної сумісності для забезпечення можливості безпечного відкату.
Яка різниця між показниками RTO та RPO?
RTO (Recovery Time Objective) визначає допустиму тривалість відновлення працездатності системи після збою. RPO (Recovery Point Objective) вказує на допустиму точку в минулому, до якої мають бути відновлені дані без критичних втрат для бізнесу.
Джерела
- Strangler Fig pattern - Microsoft Azure Architecture Center
- Architecture strategies for safe deployment practices - Microsoft Azure Well-Architected Framework
- Service Level Objectives - Google Site Reliability Engineering
- SP 800-34 Rev. 1 — Contingency Planning Guide for Federal Information Systems - NIST